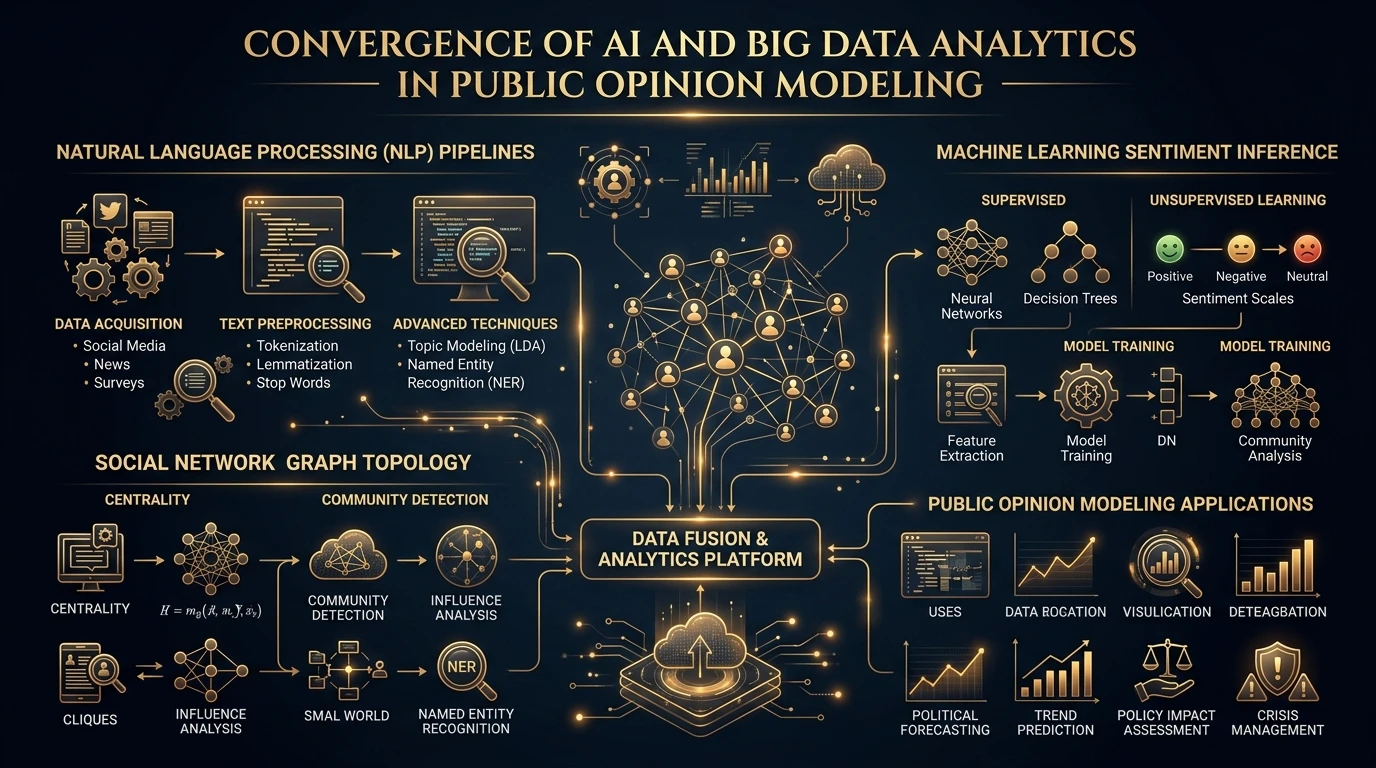
Perkembangan teknologi kecerdasan buatan mentransformasi pendekatan metodologis dalam ilmu sosial kontemporer. Melalui integrasi pemrosesan bahasa alami (natural language processing) dan penambangan data berskala besar, fenomena komunikasi massa kini dapat dianalisis dengan resolusi empiris yang presisi. Perubahan ini memfasilitasi transisi dari model observasi berbasis sampel kecil menuju pengolahan himpunan data populasi digital secara granular [1].
Pergeseran paradigma ini menuntut adopsi kerangka kerja komputasional terpadu yang mengintegrasikan teori komunikasi dengan analitik algoritma tingkat lanjut. Data jejak interaksi digital merekam tindakan komunikatif aktor secara kronologis, menyediakan peluang untuk memvalidasi hipotesis dinamika opini publik tanpa terdistorsi oleh bias ingatan subjek penelitian [2].
Topologi Jaringan Sosial dan Dinamika Polarisasi Publik
Dalam analisis struktur komunikasi digital, pemodelan berbasis simpul (nodes) dan relasi (edges) menyajikan representasi topologis distribusi pesan. Identifikasi aktor kunci (key opinion leaders) tidak didasarkan pada metrik kuantitas pengikut semata, melainkan dihitung berdasarkan metrik derajat sentralitas (degree centrality), kedekatan (closeness centrality), dan keantaraan (betweenness centrality) [3].
Struktur graf jejaring memungkinkan deteksi formasi kluster (community detection) yang mencerminkan segregasi pandangan ideologis. Algoritma modularitas graf memetakan densitas interaksi antar-kelompok, memperlihatkan kecenderungan terbentuknya ruang gema (echo chambers) di mana sirkulasi informasi berlangsung secara homogen dan menutup paparan informasi heterogen [5].
"Kode pemrograman dan arsitektur algoritma kurasi konten berfungsi sebagai aktor non-manusia yang memiliki agensi struktural dalam mendistribusikan visibilitas wacana publik."
Pemrosesan Bahasa Alami dan Ekstraksi Semantik
Penerapan metode pemrosesan teks algoritmik memungkinkan kuantifikasi data tekstual yang tidak terstruktur ke dalam parameter numerik. Model pemodelan topik laten (Latent Dirichlet Allocation) dan representasi vektor kata kontekstual memfasilitasi identifikasi bingkai wacana (framing) secara otomatis dari jutaan dokumen percakapan daring [4].
Keunggulan metode ini terletak pada kemampuannya mengekstraksi dimensi afektif dan polaritas sentimen terhadap suatu kebijakan atau isu publik secara longitudinal. Kendati demikian, klasifikasi otomatis menuntut adaptasi korpus terhadap nuansa semantik bahasa daerah, ragam bahasa informal, serta sarkasme linguistik guna mempertahankan validitas konstruk pengukuran.
Validitas Representasional dan Etika Riset Data
Pemanfaatan big data dalam sains komunikasi tetap menghadapi tantangan metodologis yang fundamental. Jejak digital di platform media sosial bukan representasi langsung dari opini publik agregat nasional, melainkan mencerminkan perilaku demografi pengguna aktif yang memiliki akses konektivitas dan kecenderungan partisipasi tertentu [1].
Selain keterbatasan keterwakilan sampel (representativeness), regulasi privasi data dan transparansi algoritma platform mengharuskan peneliti mematuhi protokol etika yang ketat. Pengambilan data publik wajib menjamin anonimisasi data identitas individu dan mencegah manipulasi informasi sintetis yang dapat mengaburkan pemahaman terhadap realitas sosial yang sesungguhnya.
Daftar Referensi Akademik
- Lazer, D., Pentland, A., Adamic, L., Aral, S., Barabási, A. L., Brewer, D., ... & Van Alstyne, M. (2020). Computational social science: Obstacles and opportunities. Science, 369(6507), 1060-1062. https://doi.org/10.1126/science.aaz5458
- Nurdyansa. (2025). Komunikasi Komputasional untuk Mengukur Fenomena dalam Ilmu Sosial. Nurdyansa Academic Working Papers Series, WP-2025-CSS-01. https://nurdyansa.com/blog/komunikasi-komputasional.html
- van Atteveldt, W., & Peng, T. Q. (2018). When communication meets computation: Opportunities, challenges, and pitfalls in computational communication science. Annals of the International Communication Association, 42(2), 81-92. https://doi.org/10.1080/23808985.2018.1458084
- Grimmer, J., & Stewart, B. M. (2013). Text as data: The promise and pitfalls of automatic content analysis methods for political texts. Political Analysis, 21(3), 267-297. https://doi.org/10.1093/pan/mps028
- Bail, C. A., Argyle, L. P., Brown, T. W., Donnelly, J. P., Duke, F., Friedman, R. O., ... & Volfovsky, A. (2018). Exposure to opposing views on social media can increase political polarization. Proceedings of the National Academy of Sciences, 115(37), 9216-9221. https://doi.org/10.1073/pnas.1804840115